Pendant des années, mon IDE a été une question réglée. IntelliJ au travail, VS Code pour le reste. Et puis les agents sont arrivés, et la question s'est rouverte sans prévenir.
Mes journées ont changé. J'écris moins de code dans un fichier, je passe plus de temps à lancer des tâches, à lire des diffs, à répondre à un agent qui attend mon feu vert pendant qu'un autre tourne dans son coin. IntelliJ et VS Code n'ont pas été conçus pour ça. On y greffe un plugin Claude Code, un panneau de chat, un terminal intégré, et on se retrouve à jongler entre des fenêtres, des branches et des git stash oubliés.
Zed, c'est une autre histoire. Il a été pensé pour l'ère agentique : le protocole ACP (Agent Client Protocol) pour brancher Claude Code, Codex ou Gemini CLI directement dans l'éditeur, et depuis sa version 1.0 fin avril 2026, des agents parallèles isolés chacun dans un worktree. C'est celui qui s'approchait le plus de ce que je cherchais. Ce qui me manquait se situait autour de l'édition : des tâches qui tournent sans moi à heure fixe, un outil que l'agent sait lui-même piloter en ligne de commande, et de quoi l'étendre facilement.
J'ai testé pas mal de choses. Depuis mi-août, je suis sur Orca, et pour la première fois depuis longtemps, je n'ai pas envie de regarder ailleurs.
L'essentiel
- Quoi : Orca est un environnement de développement de bureau, open source (MIT), conçu pour faire travailler plusieurs agents de code en parallèle. Édité par Stably AI, sur macOS, Windows et Linux.
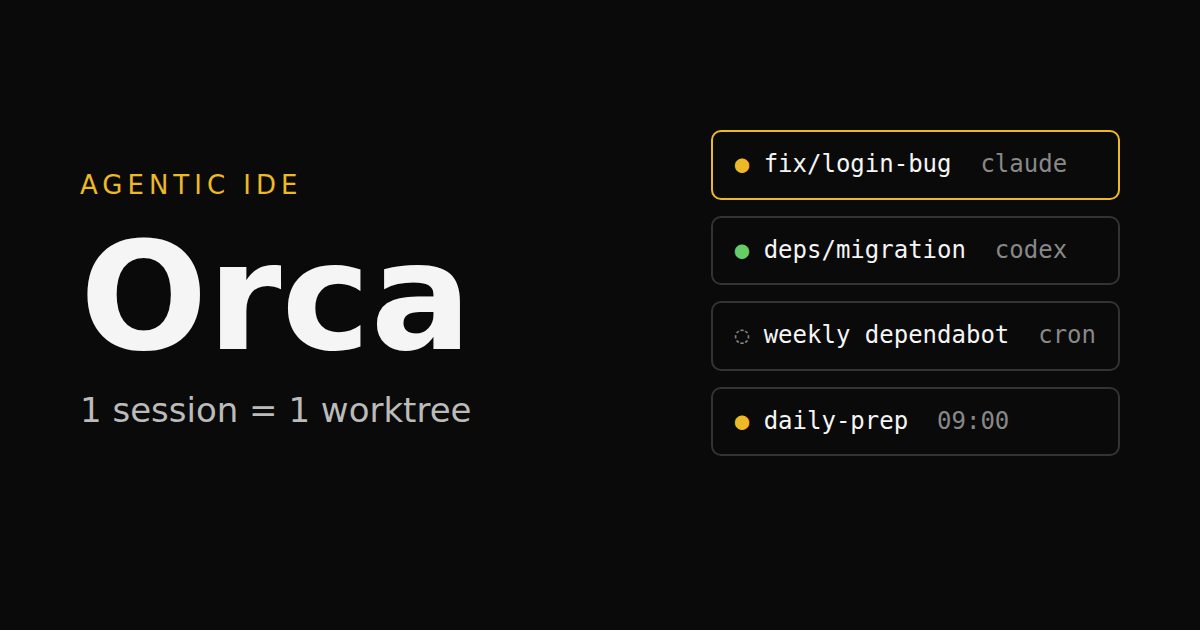
- Le principe : chaque session reçoit son propre worktree git, son terminal d'agent et son onglet de navigateur. Les agents ne se marchent plus dessus.
- Agents compatibles : Claude Code, Codex, OpenCode, Cursor CLI, GitHub Copilot CLI, Gemini, et en pratique tout agent qui tourne dans un terminal.
- Ce qui fait la différence : un dashboard des agents, des automatisations planifiées, une CLI et des skills que l'agent lui-même peut utiliser, un système de plugins.
- La limite : chaque worktree duplique les dépendances (disque, mémoire), et plus d'agents en parallèle veut dire plus de tokens et plus de diffs à relire.
Ce qu'est Orca, en deux phrases
Orca se présente comme un « agent development environment ». Concrètement, c'est une application de bureau où chaque tâche vit dans un worktree git dédié, avec un terminal pour l'agent, un éditeur de fichiers, un visualiseur de diff, un navigateur intégré et l'accès aux pull requests GitHub (et aux tickets Linear).
Le projet est open source sur GitHub, édité par Stably AI, une startup de San Francisco. Il a démarré au printemps 2026 et a accumulé des dizaines de milliers d'étoiles en quelques mois, avec des releases presque quotidiennes. C'est un outil jeune, et ça se sent parfois. J'y reviens plus bas.
Ce qu'Orca n'est pas : un agent. Il n'a pas de modèle à lui. Il orchestre ceux que vous utilisez déjà. Moi, c'est surtout Claude Code, mais rien n'empêche d'en lancer un autre dans l'onglet d'à côté.
Un worktree par session : le déclic
Si je ne devais garder qu'une chose, ce serait celle-là.
Un worktree git, pour ceux qui n'ont jamais eu à s'en servir, c'est un deuxième dossier de travail rattaché au même dépôt, mais sur une autre branche. Même historique, fichiers séparés. J'en parlais déjà dans l'article sur Claude Code et les workflows Git comme d'une astuce pour les utilisateurs avancés. Orca en fait la brique de base depuis son premier commit : chaque nouvelle session crée son worktree, sa branche, son terminal. Zed a adopté le même principe pour ses agents parallèles, ce qui montre bien que c'est la bonne idée. Dans Orca, il s'applique à n'importe quel agent en ligne de commande et à plusieurs dépôts à la fois.
L'effet sur ma façon de travailler a été immédiat. Avant, lancer deux agents sur le même projet, c'était prendre le risque qu'ils modifient le même fichier en même temps, ou que l'un lise le code à moitié réécrit par l'autre. Donc je ne le faisais pas. Je sérialisais. Une tâche, j'attends, je relis, la suivante.
Aujourd'hui, j'ouvre une session pour corriger un bug, une autre pour la migration d'une dépendance, une troisième pour explorer une idée que je jetterai peut-être. Chacune avance dans son coin. Quand l'une est prête, je relis le diff, je pousse, j'ouvre la PR, et je supprime le worktree. Les autres n'ont rien vu.
C'est ce que j'appelle multiplexer. Le code ne sort pas plus vite d'une session, mais plus rien n'attend que la précédente soit finie. Et ça marche aussi à travers les projets : trois dépôts différents, chacun avec ses sessions, dans la même fenêtre.
Le prix à payer est réel. Chaque worktree a son propre node_modules (ou son équivalent), donc le disque se remplit vite sur un gros projet. Un retour d'expérience publié par Margrop estime la mémoire à environ 2 Go par agent actif, soit une dizaine de gigas pour cinq agents en parallèle. Je n'ai pas mesuré aussi finement, mais l'ordre de grandeur me paraît juste. Orca permet de déporter des worktrees sur une machine distante en SSH, ce qui règle une partie du problème.
Le dashboard : savoir qui attend quoi
Lancer cinq sessions, c'est facile. Savoir laquelle attend une réponse depuis vingt minutes, c'est une autre affaire.
Orca affiche l'état de chaque agent : en train de travailler, terminé, ou bloqué sur une demande de permission. Il y a une vue d'ensemble qui rassemble toutes les sessions, avec des notifications quand un agent a besoin de vous. Ça paraît anecdotique. En pratique, c'est ce qui rend le parallélisme tenable. Sans ça, je passais mon temps à faire le tour des terminaux pour vérifier si quelqu'un avait fini.
Il existe aussi une application mobile (iOS et Android) pour suivre les agents et leur envoyer une relance depuis son téléphone. Utile le jour où une session attend une validation pendant que vous êtes loin du bureau.
Claude Code, Codex, ou ce que vous voulez
Orca n'impose pas d'agent. Il lance ce qui tourne dans un terminal : Claude Code, Codex, OpenCode, Cursor CLI, GitHub Copilot CLI, Gemini, et une longue liste d'autres. On peut même envoyer le même prompt à plusieurs agents différents, chacun dans son worktree, et comparer les résultats. Zed permet aussi de changer d'agent via ACP ; Orca, lui, se contente d'un terminal, donc un agent n'a besoin d'aucune intégration particulière pour y tourner.
Pour moi, c'est un point important. J'ai passé assez de temps à comparer les outils (Claude Code, Cursor et Copilot, notamment) pour savoir qu'aucun n'est définitif. Je n'ai pas envie que mon environnement de travail dépende d'un seul fournisseur. Avec Orca, si demain un autre agent fait mieux sur un type de tâche, je l'ajoute dans un onglet. Mes habitudes, mes raccourcis, mes worktrees restent les mêmes.
Les tâches planifiées, ou l'agent qui travaille le lundi matin
C'est la fonctionnalité que je n'attendais pas et dont je me sers le plus.
Orca a un système d'automatisations : un prompt, un agent, un dépôt ou un worktree, et un calendrier. Le calendrier accepte des raccourcis (hourly, daily, weekdays, weekly), une expression cron ou une règle RRULE, avec gestion du fuseau horaire. On peut aussi définir une vérification préalable, une petite commande shell qui annule l'exécution si elle échoue, pour ne pas brûler des tokens pour rien.
J'en ai deux qui tournent en permanence.
Le suivi Dependabot, une fois par semaine. Sur mes dépôts, les PR de Dependabot s'accumulent. Individuellement, elles sont triviales. Collectivement, personne ne veut s'en occuper. Maintenant, chaque semaine, un agent passe dessus, regarde lesquelles passent la CI, lesquelles cassent quelque chose, et me prépare un résumé de ce qui peut être fusionné tel quel et de ce qui mérite qu'on s'y penche. Je garde la main sur la fusion. Mais le tri est fait quand j'arrive.
La préparation du daily d'équipe. Chaque matin de semaine, un agent rassemble ce qui a bougé depuis la veille : PR ouvertes et fusionnées, revues en attente, tickets qui ont changé d'état. J'arrive au daily avec une vue claire au lieu de reconstituer de mémoire ce que j'ai fait hier.
Voici à quoi ressemble la création d'une automatisation en ligne de commande (les noms de dépôt et le prompt sont des exemples) :
orca automations create \
  --name "Dependabot hebdo" \
  --trigger "0 8 * * 1" \
  --timezone Europe/Paris \
  --prompt "Liste les PR Dependabot ouvertes, vérifie leur CI et résume ce qui peut être fusionné" \
  --provider claude \
  --repo mon-depot
Ensuite, orca automations list, run ou edit pour les gérer. L'interface graphique fait la même chose, avec des modèles prêts à l'emploi.
La CLI et les skills : Claude Code s'occupe du reste
C'est là que j'ai compris qu'Orca avait été pensé par des gens qui travaillent vraiment avec des agents.
Tout ce que fait l'interface est accessible par la CLI orca : créer un worktree, lire la sortie d'un terminal, envoyer une commande à un autre terminal, ouvrir un fichier, piloter le navigateur intégré, gérer les automatisations. Et Orca fournit des skills (au sens de ceux de Claude Code) qui apprennent à l'agent à se servir de cette CLI. Ils s'installent en une commande :
npx skills add https://github.com/stablyai/orca --skill orca-cli --globalLe résultat, c'est que je ne configure presque plus rien à la main. Je demande à Claude Code de créer l'automatisation Dependabot, de préparer trois worktrees pour une série de tickets, ou d'ajouter un nouveau projet à Orca. Il le fait. Ce qu'on configurait autrefois dans des menus, on le décrit maintenant en une phrase à l'agent qui a les outils pour le faire.
Il existe d'autres skills pour l'orchestration multi-agents (un agent qui distribue du travail à d'autres), Linear, ou le pilotage des émulateurs iOS et Android.
Les plugins : j'ai fait le mien pour suivre ma consommation
Dernier point, et le plus récent : Orca a un système de plugins. Il est encore jeune (marqué expérimental à son introduction, et les issues du dépôt montrent que l'API s'étoffe au fil des demandes), mais il permet déjà d'ajouter des panneaux, des commandes, des raccourcis, et d'écouter les événements de l'application.
J'avais un besoin précis. Quand on lance beaucoup d'agents en parallèle, la consommation monte, et elle monte sans prévenir. J'avais déjà écrit sur la facturation de Claude Code, mais je manquais d'une vue simple de où partaient les tokens.
Alors j'ai fait un plugin. Il m'affiche ma consommation par projet et par modèle, avec une vue au mois, et il remonte les sessions les plus gourmandes. C'est cette dernière vue que je regarde le plus. Une exploration trop vague, un agent qui tourne en boucle sur un test qui ne passe pas : ce genre de session se repère tout de suite en haut de la liste, et ça pousse à mieux cadrer ses prompts.
Et comme pour le reste, c'est Claude Code qui a écrit l'essentiel du plugin, à partir de la documentation et de l'API exposée par Orca.
Ce qui coince encore
Je ne vais pas faire semblant que tout est parfait.
Le rythme des mises à jour. Des releases presque tous les jours, c'est bien pour les nouveautés, moins pour la stabilité. Il faut accepter que l'outil bouge sous vos pieds.
Les ressources. J'en parlais plus haut : disque, mémoire, et surtout tokens. Cinq agents en parallèle, c'est potentiellement cinq fois la consommation. L'outil rend le parallélisme facile, il ne le rend pas gratuit.
La relecture. Plus d'agents, c'est plus de code produit, donc plus de diffs à lire. Orca aide (annotations sur les diffs, revue de PR intégrée), mais le goulet d'étranglement, c'est moi. Si je ne relis pas, je ne devrais pas fusionner.
L'éditeur. Orca n'est pas compatible avec les extensions VS Code. Pour une grosse session de refactoring à la main, avec le débogueur et tout l'outillage d'un langage, IntelliJ garde de l'avance. Pour moi, c'est devenu l'exception.
Six semaines après
Ce qui a changé, au fond, c'est la nature de mon poste de travail. Il n'est plus organisé autour d'un fichier ouvert. Il est organisé autour de tâches en cours, chacune dans sa boîte, avec quelqu'un (quelque chose) qui travaille dessus pendant que je fais autre chose.
IntelliJ et VS Code restent d'excellents éditeurs, conçus autour de quelqu'un qui écrit du code. Zed a fait le chemin vers les agents, et bien. Orca part directement de quelqu'un qui fait travailler des agents, les planifie, les surveille et relit ce qu'ils produisent. C'est ce que je fais la plupart du temps désormais, et c'est pour ça que je suis resté.
Si vous voulez essayer : c'est gratuit, ça s'installe en quelques minutes depuis onorca.dev, et vos agents actuels marchent dedans tels quels. Commencez par deux sessions en parallèle sur un projet que vous connaissez bien. Vous verrez vite si ça vous parle.
Questions fréquentes
- Qu'est-ce qu'Orca ?
- Orca est un environnement de développement de bureau, open source sous licence MIT, conçu pour faire travailler plusieurs agents de code en parallèle. Chaque tâche y reçoit son propre worktree git, son terminal d'agent et son onglet de navigateur. Il est édité par Stably AI et disponible sur macOS, Windows et Linux.
- Orca est-il gratuit ?
- Oui. Orca est gratuit et open source (licence MIT). En revanche, les agents qu'on y lance restent payants selon leur propre modèle : un abonnement ou une clé API Anthropic pour Claude Code, OpenAI pour Codex, etc.
- Orca fonctionne-t-il avec Claude Code ?
- Oui. Orca lance n'importe quel agent en ligne de commande dans un terminal : Claude Code, Codex, OpenCode, Cursor CLI, GitHub Copilot CLI, Gemini et d'autres. On peut même en faire tourner plusieurs différents sur la même tâche, chacun dans son worktree.
- Pourquoi Orca utilise-t-il des worktrees git ?
- Un worktree git est un deuxième répertoire de travail rattaché au même dépôt, sur une autre branche. En donnant un worktree à chaque session, Orca évite que deux agents modifient les mêmes fichiers en même temps : chacun travaille dans son dossier, et on fusionne ensuite par pull request.
- Quelle différence entre Orca et Zed ?
- Zed est un éditeur de code rapide pensé pour les agents : il intègre Claude Code et d'autres via le protocole ACP et, depuis sa version 1.0 (avril 2026), fait tourner des agents parallèles dans des worktrees git. Orca est un environnement construit autour de l'orchestration : il lance n'importe quel agent en terminal et ajoute des automatisations planifiées, une CLI pilotable par les agents et un système de plugins.
- Peut-on planifier des tâches récurrentes dans Orca ?
- Oui. Les automatisations d'Orca lancent un agent avec un prompt donné selon un calendrier (hourly, daily, weekdays, weekly, expression cron ou RRULE), sur un dépôt ou un worktree précis. Elles se créent depuis l'interface ou avec la commande orca automations create.